La désynchronisation expliquée : causes, rubberbanding et correctifs côté serveur

La désynchronisation est un désaccord, pas un retard : Le lag signifie que l'information arrive tardivement. La désynchronisation signifie que deux machines détiennent des versions différentes du même monde, ce qui est une défaillance distincte avec des corrections distinctes.
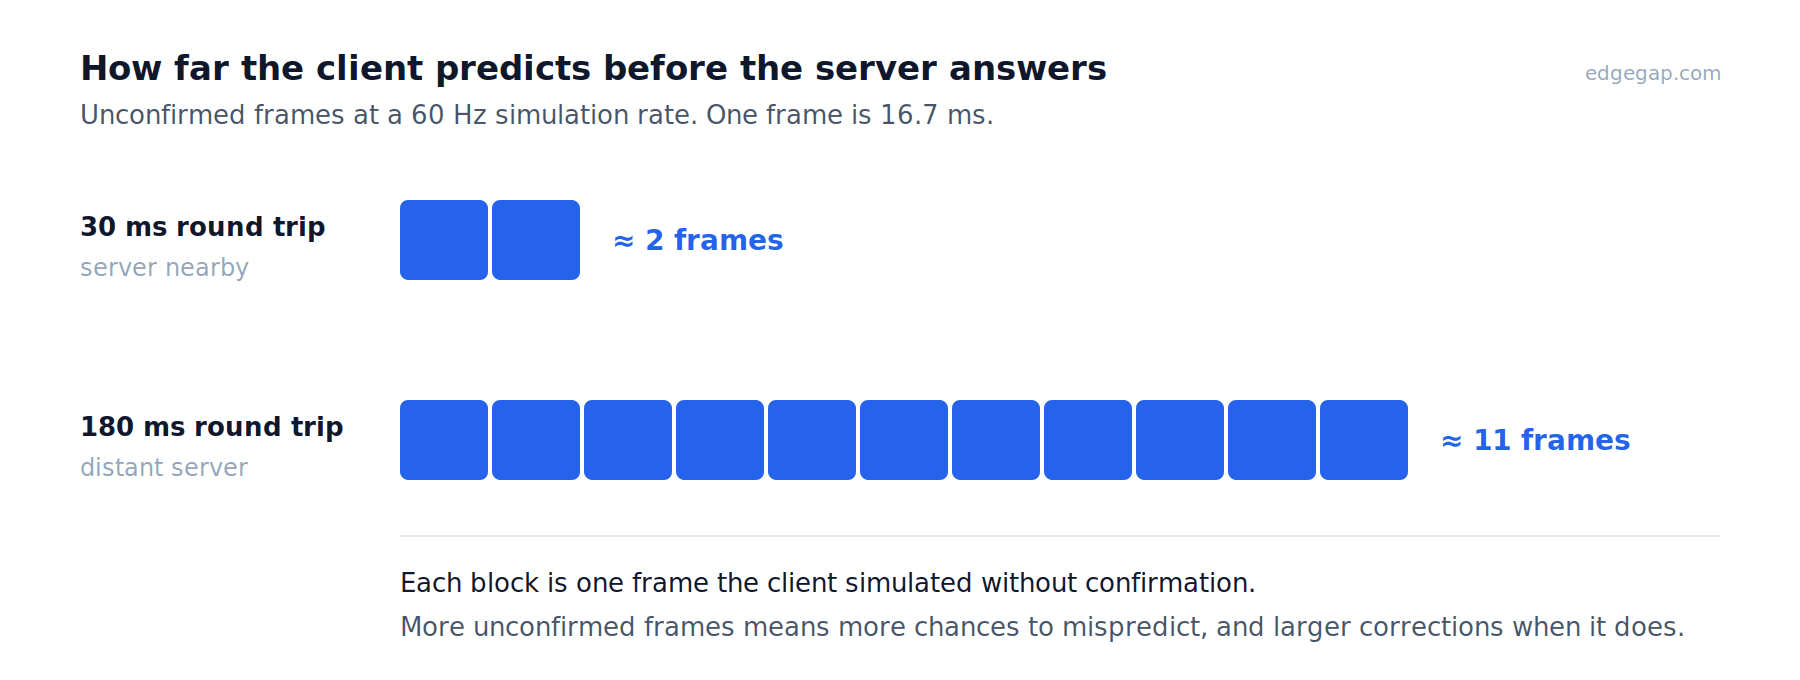
Il en existe deux types distincts : La désynchronisation de réplication, où un serveur faisant autorité corrige un client qui a mal deviné, et la désynchronisation de déterminisme, où les simulations des pairs divergent et la session s'arrête carrément.
L'effet d'élastique (rubberbanding) a deux leviers : La fréquence à laquelle le client fait de mauvaises prédictions, qui dépend de la latence, et la visibilité de chaque correction, qui dépend du netcode. Modifiez l'un ou l'autre de ces leviers et les joueurs le verront moins.
Le tick rate (taux de rafraîchissement) n'est aucun de ces leviers : L'augmenter ne rend pas les prédictions plus précises, et sur une connexion qui perd déjà des paquets, cela aggrave les artefacts.
« Une désynchronisation s'est produite » est un échec de checksum (somme de contrôle) : Les jeux en lockstep comparent les hachages d'état à chaque tour, donc un seul flottant divergent ou un seul appel aléatoire non synchronisé met fin à la session.
Deux articles présentés lors de la GDC 2001 expliquent encore la majeure partie de ce qui ne va pas dans les jeux multijoueurs vingt-cinq ans plus tard. Yahn W. Bernier, alors développeur chez Valve, a publié Latency Compensating Methods in Client/Server In-game Protocol Design and Optimization, décrivant comment Half-Life masquait le délai réseau derrière la prédiction et la compensation du décalage côté serveur. Paul Bettner et Mark Terrano, alors chez Ensemble Studios, ont publié 1500 Archers on a 28.8: Network Programming in Age of Empires and Beyond, décrivant comment un jeu de stratégie en temps réel maintenait des milliers d'unités synchronisées via un modem bas débit, et ce qui se passait lorsque ce n'était pas le cas.
Entre eux, ces deux articles décrivent deux modes de défaillance entièrement différents. Les joueurs et les développeurs désignent aujourd'hui ces deux phénomènes par un même mot : la désynchronisation (desync).
Savoir à quel cas de figure vous êtes confronté représente l'essentiel du travail, car les correctifs ne se recoupent pas.
Qu'est-ce que la désynchronisation dans un jeu multijoueur ?
La désynchronisation, ou desync, se produit lorsque deux machines d'une même session ne s'accordent pas sur l'état du monde du jeu. Votre client pense que vous êtes debout derrière un mur. Le serveur pense que vous êtes toujours dans l'embrasure de la porte. Les deux sont cohérents en interne. Un seul d'entre eux fait autorité.
Les symptômes sont familiers à quiconque joue en ligne. Des tirs qui traversent un joueur qui était pourtant clairement dans le réticule. Des dégâts subis une seconde entière après s'être mis à l'abri. Un personnage qui recule de trois mètres sans raison visible. Une porte qui s'ouvre, se ferme et s'ouvre à nouveau. Dans les jeux au tour par tour et de simulation, le symptôme est plus net : le jeu s'arrête et vous indique qu'une désynchronisation s'est produite.
Ceux-ci ressemblent à des bugs différents. En réalité, il s'agit de la même catégorie de problème qui se manifeste dans deux architectures réseau très différentes.
Désynchronisation vs Lag : quelle est la différence ?
Le lag est un problème de timing. Les informations arrivent en retard, mais tout le monde finit par s'accorder sur ce qui s'est passé. Un jeu avec un ping de 200 ms qui ne se désynchronise jamais est lent mais parfaitement cohérent.
La désynchronisation est un problème de justesse. Les machines sont parvenues à des réponses différentes et, sans intervention, elles continueront à diverger.
Le lag est lent. La désynchronisation est fausse.
Les deux sont liés, car la latence est l'une des conditions qui augmentent la probabilité de divergence, mais ils ne sont pas interchangeables. Vous pouvez avoir une désynchronisation à 20 ms de ping en raison d'un bug de virgule flottante, et vous pouvez jouer à 150 ms de ping sans aucune désynchronisation.
Désynchronisation de réplication : quand le serveur l'emporte sur le client
La plupart des jeux d'action, de tir et de battle royale utilisent un serveur faisant autorité (authoritative server). Le serveur détient le véritable état du jeu, les clients envoient les commandes et le serveur renvoie la vérité.
Attendre un aller-retour réseau avant que votre personnage ne bouge est une expérience terrible. C'est ce que la documentation de SnapNet appelle le délai d'entrée (input delay), où les clients « envoient leurs commandes au serveur puis, lorsqu'ils reçoivent les résultats de la simulation du serveur, ils affichent ces résultats au joueur ». C'est simple et cela ne fait jamais de mauvaise prédiction. Cela lie également directement la réactivité de votre jeu au ping de chaque joueur.
C'est pourquoi la plupart des jeux au rythme effréné utilisent plutôt la prédiction. Comme le décrit Gabriel Gambetta dans sa série Fast-Paced Multiplayer, « nous pouvons envoyer les commandes au serveur et les traiter immédiatement sur le client, c'est-à-dire que nous prédisons ce que sera l'état du jeu après que le serveur aura traité les commandes ».
Lorsque la prédiction correspond à ce que le serveur confirme ultérieurement, le joueur ne remarque absolument rien. La prédiction est invisible lorsqu'elle fonctionne.
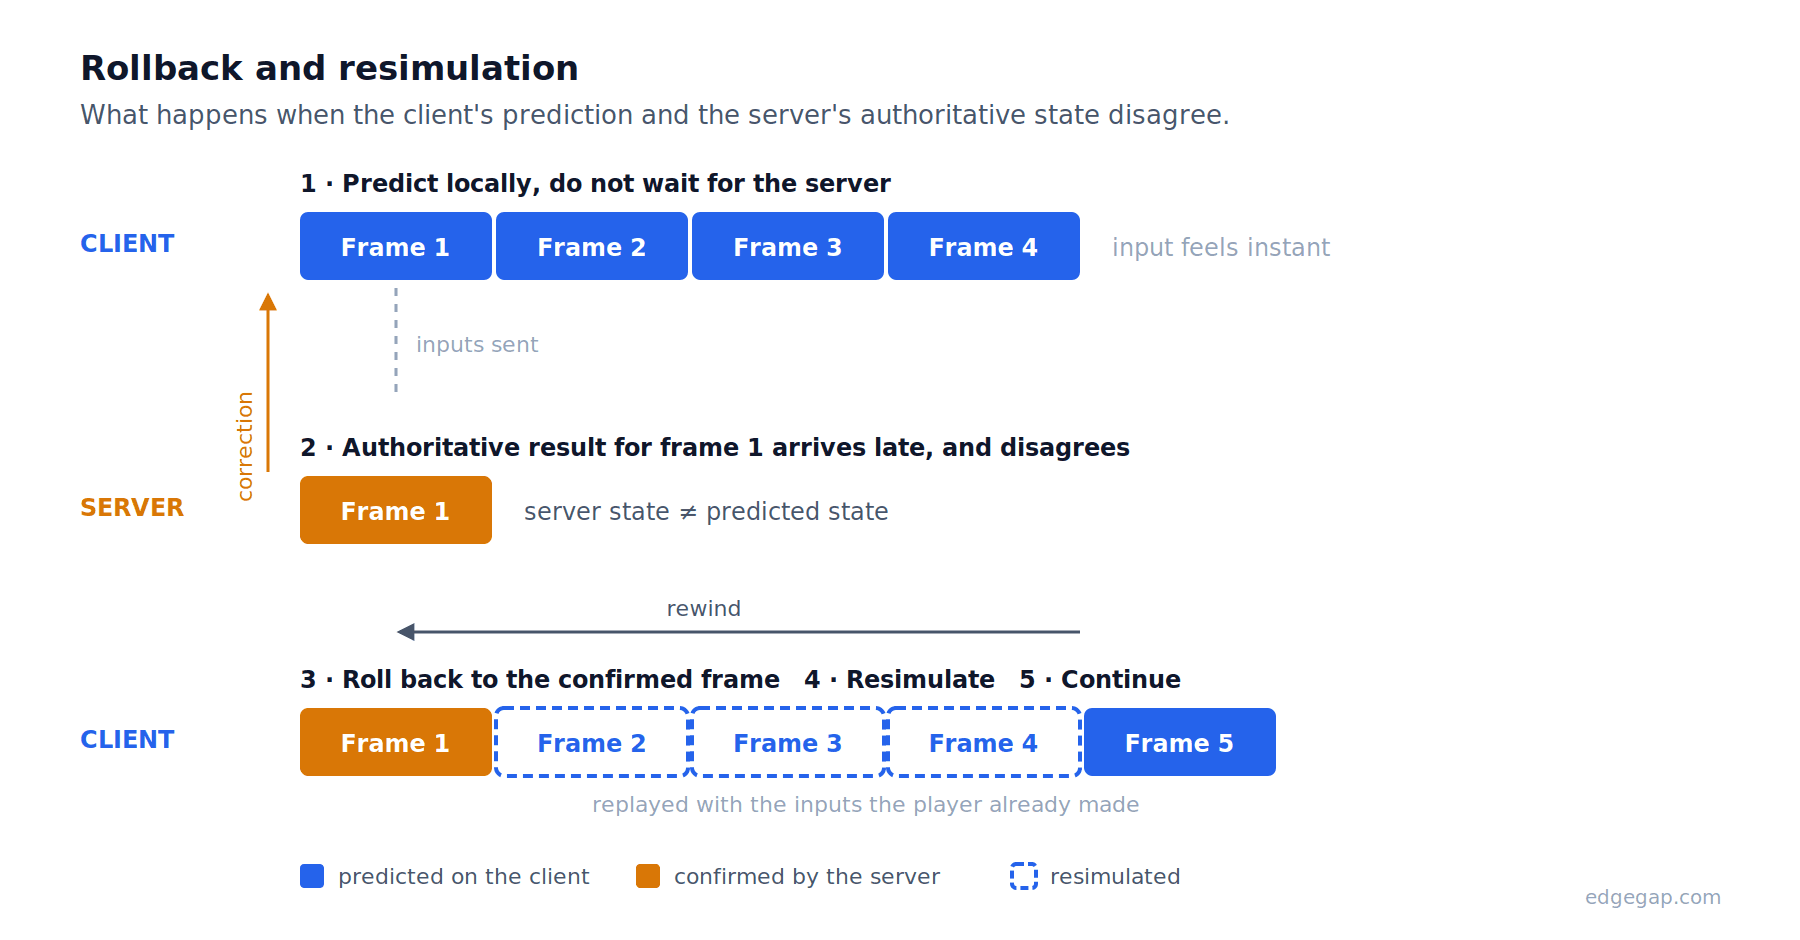
Lorsque la prédiction ne correspond pas, c'est la version du serveur qui l'emporte, et le client doit être aligné de force. Il s'agit d'une désynchronisation de réplication, et le joueur la perçoit comme une correction.
L'article de Bernier couvre l'autre aspect de ce même compromis. Étant donné que chaque client affiche une vue du monde légèrement retardée, le serveur remonte le temps dans son propre historique pour évaluer un tir par rapport à ce que le tireur a réellement vu. C'est cette technique qui rend la validation des tirs (hit registration) juste pour la personne qui appuie sur la gâchette. C'est aussi la raison pour laquelle la personne visée meurt parfois après avoir pensé s'être mise à l'abri. Ce désaccord n'est pas un dysfonctionnement. C'est un choix délibéré sur la vue à privilégier.
Pourquoi le rubberbanding se produit-il ?
Le rubberbanding (effet élastique) est la manifestation visible de la correction d'une mauvaise prédiction. La description que fait Gambetta de ce comportement brut est exacte : le personnage « s'est déplacé de deux cases vers la droite, y est resté pendant 50 ms, a sauté d'une case vers la gauche, y est resté pendant 100 ms et a sauté d'une case vers la droite ».
La documentation des concepts fondamentaux de SnapNet expose clairement le compromis : « des artefacts visuels et des bugs peuvent survenir lorsque le client prédit mal les résultats de la simulation », et ils se manifestent couramment « sous la forme d'objets qui se téléportent ou apparaissent/disparaissent spontanément ».
Ce qui signifie que le rubberbanding n'est jamais le problème de fond. C'est le produit de deux facteurs combinés : la fréquence à laquelle le client se trompe dans ses prédictions, et l'intensité avec laquelle chaque mauvaise prédiction apparaît à l'écran. La latence, le jitter et la perte de paquets entraînent le premier. Le netcode régit le second. Les deux sont de vrais leviers, et une équipe qui n'en connaît qu'un seul passera des mois sur la mauvaise tâche.
Levier un : réduire la latence
L'erreur de prédiction augmente proportionnellement au temps de trajet aller-retour. Chaque milliseconde entre un client et son serveur est une image supplémentaire de simulation que le client réalise de son côté, sans confirmation, en ne se basant que sur sa propre prédiction.
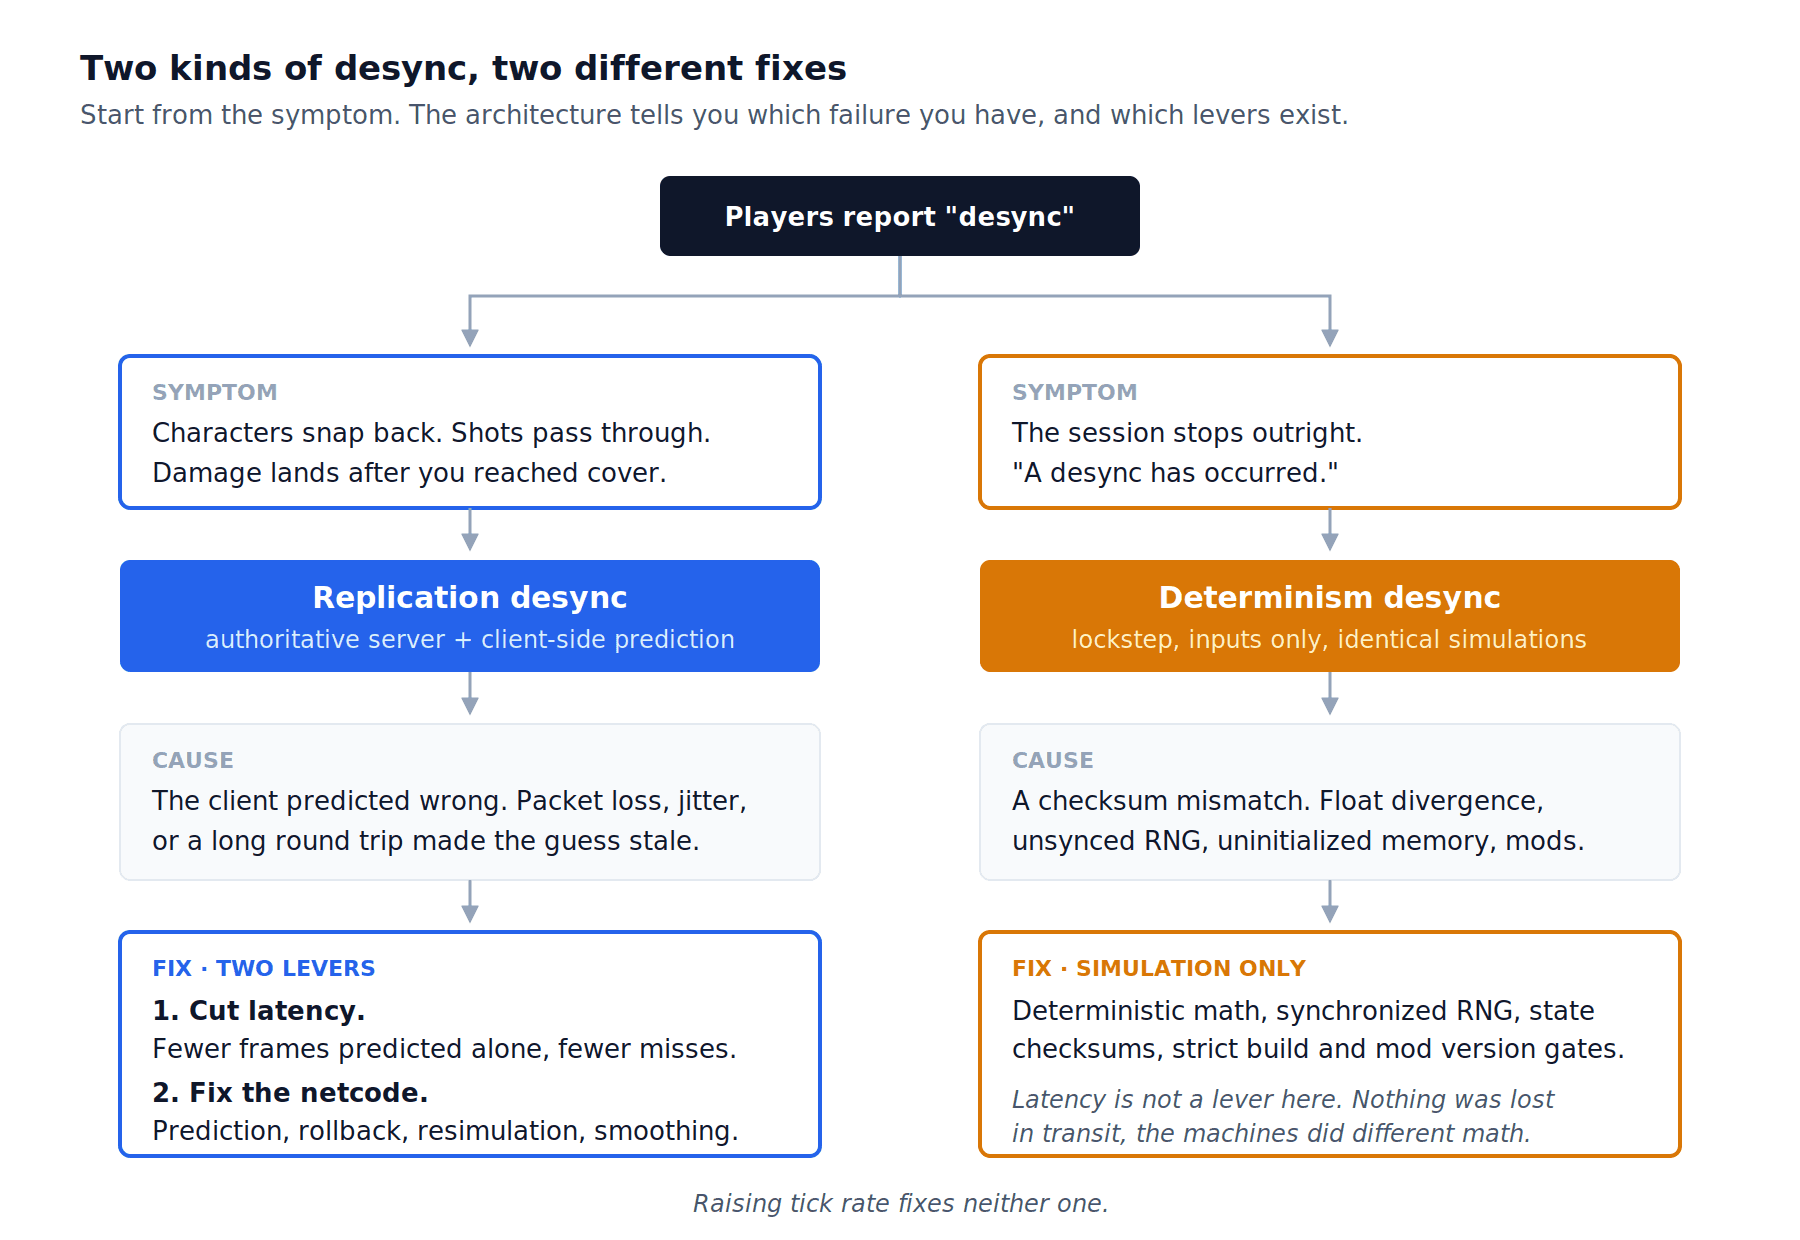
À un taux de simulation de 60 Hz, un client situé à 30 ms de son serveur tourne environ deux images en avance sur la réalité. À 180 ms, il en a environ onze d'avance. Même code, même moteur, même joueur. Une exposition cinq fois plus grande.
C'est pour cela qu'un jeu avec un netcode médiocre peut sembler acceptable à 50 ms et s'effondrer à 150 ms. Les corrections ont toujours eu lieu. À courte distance, elles étaient suffisamment petites pour que l'interpolation les absorbe avant que quiconque ne s'en aperçoive. Augmentez l'écart et ces mêmes corrections deviennent des saccades visibles. La perte de paquets et le jitter aggravent la situation, car un paquet d'entrée perdu signifie que le serveur progresse sans tenir compte du tout de l'action du joueur.
Ainsi, le correctif le plus économique pour la plupart des studios ne nécessite aucun code. Rapprochez le serveur. Se déployer dans plus de 615 emplacements plutôt que dans une poignée de grandes régions permet d'obtenir une réduction moyenne de la latence de 58 % et des connexions inférieures à 50 ms pour 78 % des joueurs. Une équipe qui divise par deux son temps de trajet moyen a environ divisé par deux l'ampleur du problème que son netcode doit résoudre, sans déployer de patch. L'argumentation complète de cette approche est présentée dans For True Latency Reduction, the Only Answer Is More Locations.
Pourquoi augmenter le tick rate est le mauvais levier d'infrastructure
Les studios qui cherchent un correctif d'infrastructure se tournent généralement d'abord vers le tick rate (taux de rafraîchissement du serveur). C'est une erreur.
Le tick rate détermine la fréquence à laquelle le serveur résout et diffuse l'état du monde. L'augmenter offre une meilleure résolution temporelle, ce qui est très important pour la précision de la validation des tirs. Cela n'améliore en rien la précision de la prédiction, car celle-ci dépend de votre code de simulation et des commandes qui ont atteint le serveur, et non de la fréquence à laquelle le serveur communique.
En revanche, cela augmente à coup sûr le volume des messages. Un joueur victime de rubberbanding parce que sa connexion perd des paquets reçoit désormais deux fois plus de paquets à perdre. Les corrections arrivent plus souvent et les artefacts visuels s'aggravent.
Le tick rate est une décision de précision et de coût, que nous avons analysée dans Game Server Tick Rate Explained. La latence est le levier d'infrastructure qui influe sur la désynchronisation. Le tick rate ne l'est pas.
Levier deux : corriger le netcode
Une latence plus faible réduit le problème. Elle ne l'élimine jamais, car même à 20 ms, le client continue de faire des prédictions, et un jeu déployé sans prédiction semble lent, même en réseau local (LAN). Quatre mécanismes se chargent du reste du travail.
La prédiction côté client exécute la simulation localement à l'instant même où le joueur appuie sur une touche, de sorte que l'action semble immédiate, quel que soit le ping. Tout le reste est construit par-dessus.
Le rollback (retour en arrière) gère le moment où l'état faisant autorité du serveur arrive et contredit celui du client. Plutôt que de se caler brutalement sur le nouvel état en ignorant tout ce qui s'est produit depuis, le client revient à la dernière image confirmée.
La resimulation rejoue les images intermédiaires à partir de cet état confirmé en appliquant les commandes que le joueur a effectuées entre-temps. SnapNet décrit cette séquence comme « le retour de la simulation du client aux résultats de l'image 1, la resimulation des images 2 et 3, puis enfin la simulation de la nouvelle image ». Si cela est bien fait, la plupart des corrections se résolvent sans que le joueur ne voie quoi que ce soit, car le résultat rejoué retombe très près de l'endroit où il se trouvait déjà.
Le lissage de présentation gère ce qui subsiste après cela. Séparer le code visuel cosmétique du code de simulation permet d'interpoler visuellement une position corrigée sur quelques images au lieu de la téléporter. La séparation de SnapNet entre simulation et présentation existe pour cette raison : le code du gameplay peut s'exécuter plusieurs fois par image rendue, tandis que « toute logique purement cosmétique qui n'affecte pas la simulation peut n'être exécutée qu'une seule fois par image ».
Il existe un cinquième facteur qui explique pourquoi certaines corrections sont plus brutales que d'autres. Une commande ne conserve pas la même autorité indéfiniment. Dès qu'un joueur appuie sur une touche, la précision de cette commande diminue à mesure qu'elle traverse le réseau et que le joueur continue d'en envoyer d'autres par-dessus. Un tir effectué il y a 20 ms est une affirmation forte sur l'état du monde. Ce même tir, toujours non confirmé 200 ms plus tard alors que le joueur a déjà fait un pas de côté, a tourné et a tiré deux fois de plus, est une affirmation bien plus faible. Une réconciliation qui traite les deux avec la même confiance va soit corriger de manière excessive les commandes récentes, soit défendre obstinément des données obsolètes.
Tout cela consomme du processeur (CPU). La réconciliation, comme le note SnapNet, « engendre un coût CPU élevé », car une seule image affichée peut nécessiter de revenir en arrière et de rejouer plusieurs images de simulation. Pour les équipes qui hésitent entre délai d'entrée et rollback avant de se lancer, nous les avons comparés directement dans How to Mitigate Latency in Multiplayer Games: Input Delay vs Rollback.
Aucun levier ne remplace l'autre. Un bon netcode à 200 ms produit toujours des corrections visibles. Un routage parfait sur un jeu sans prédiction semble toujours mou. Les studios qui proposent un multijoueur fluide activent les deux leviers.
Désynchronisation de déterminisme : pourquoi « Une désynchronisation est survenue »
La deuxième catégorie fonctionne de manière totalement différente de la première, et elle est à l'origine des plaintes les plus vives sur internet actuellement.
Les jeux de stratégie, les titres 4X, les simulations de grande stratégie, les jeux de sport et beaucoup de jeux en coopération ne diffusent pas du tout l'état du monde en continu. Ils utilisent le lockstep (synchronisation stricte). Chaque machine exécute exactement la même simulation, et les seules données envoyées sur le réseau sont les actions des joueurs. Bettner et Terrano ont utilisé cette méthode pour déplacer 1 500 unités via un modem 28.8k, ce que la diffusion de données de position en temps réel n'aurait jamais permis de faire.
La contrainte est absolue. Chaque machine doit calculer des résultats identiques au bit près, indéfiniment. Pour s'en assurer, les jeux en lockstep calculent régulièrement une somme de contrôle (checksum) de leur état et la comparent. Une divergence ne peut pas être réparée en demandant un renvoi, car il n'existe pas de copie faisant autorité à renvoyer. Le jeu s'arrête donc et signale l'erreur.
C'est ce que signifie « une désynchronisation est survenue ». Une comparaison de somme de contrôle a échoué.
Bettner et Terrano ont documenté à quel point ce système est fragile. « Un cerf légèrement décalé lors de la création de la carte aléatoire se nourrissait de manière un peu différente », ont-ils écrit, « et quelques minutes plus tard, un villageois se déplaçait d'un millimètre à côté, ou ratait sa cible avec sa lance et rentrait chez lui les mains vides. » La difficulté principale, selon leurs termes : « des différences infimes finissent par se multiplier au fil du temps ».
Leur équipe a multiplié les sommes de contrôle de manière agressive et a tout de même perdu du terrain. « Même si nous calculions les checksums pour le monde, les objets, la recherche de chemin, le ciblage et tous les autres systèmes, il semblait qu'il y avait toujours un détail supplémentaire qui passait entre les mailles du filet. »
Les coupables habituels n'ont pas changé depuis 2001. Les calculs en virgule flottante qui s'arrondissent différemment selon les architectures de processeur, les compilateurs ou les plateformes. Des générateurs de nombres aléatoires sollicités un nombre de fois différent selon les machines, un problème que les auteurs ont directement souligné, notant que « les programmeurs n'avaient pas l'habitude de devoir écrire du code qui utilisait le même nombre d'appels à la fonction random au sein de la simulation ». La mémoire non initialisée. L'ordre d'itération des conteneurs. Les écarts de version de mods ou de patchs entre les joueurs, ce qui explique pourquoi les sessions de grande stratégie avec des mods se désynchronisent si facilement.
Aucun des leviers des sections précédentes ne s'applique ici. Réduire la latence ne sert à rien, car rien n'a été perdu pendant le transport. Une meilleure prédiction ne sert à rien non plus, car il n'y a rien à prédire. Les deux machines ont effectué des calculs différents, et une session à 15 ms de ping plante tout aussi facilement qu'une autre à 150 ms. Si votre jeu signale la désynchronisation comme une erreur fatale plutôt que comme une simple saccade, le correctif se trouve dans la simulation et nulle part ailleurs.
Un serveur dédié élimine-t-il la désynchronisation ?
Oui, et pour une raison bien plus fondamentale que ce à quoi s'attendent la plupart des équipes.
La partie évidente est la récupération. Lorsque l'état d'un client dérive de la réalité, un serveur faisant autorité peut cesser d'envoyer des deltas (l'approche habituelle et efficace consistant à ne transmettre que ce qui a changé depuis le dernier tick) et envoyer à la place l'état complet avec l'instruction de le traiter comme l'unique vérité. La copie divergente du client est simplement écrasée. Cela consomme de la bande passante, ce qui est précisément la raison pour laquelle vous envoyez des deltas le reste du temps, mais cela transforme une session irrécupérable en une simple saccade passagère.
La partie moins évidente est d'ordre architectural. Les désynchronisations en lockstep sont irrécupérables précisément parce qu'aucune machine n'a la légitimité de l'emporter sur les autres. Placez un serveur dédié faisant autorité au milieu et cette condition disparaît. Il existe par définition une source unique de vérité, de sorte que le mode de défaillance qui met fin à une partie de Civilization ne peut pas se produire de la même manière.
Les architectures peer-to-peer et de migration d'hôte renoncent à ces deux propriétés. Chaque client devient une source potentielle de vérité, les performances de la machine de l'hôte deviennent le problème de tout le monde, et une migration en plein match transfère l'autorité à une machine qui peut être en moins bon état que celle qui est partie. Nous avons détaillé les compromis entre ces modèles dans Authoritative Servers, Relays, Peer-to-Peer.
Un serveur dédié ne rend pas la prédiction inutile et ne réduit pas en soi la distance physique avec vos joueurs. Ce qu'il vous apporte, c'est un état que vous possédez, que vous pouvez analyser et que vous pouvez corriger de force.
Une précision : « Desync » désigne également une technique de triche
Ce mot comporte un troisième sens qu'il est utile de connaître avant de trier les rapports de vos joueurs.
Dans les communautés de jeux de tir compétitifs, c'est généralement un raccourci pour désigner les artefacts de compensation de latence. Rainbow Six Siege en est l'exemple type, où une analyse du netcode du jeu a révélé que des joueurs à faible ping perdaient des duels contre des joueurs à ping élevé alors qu'ils étaient à l'abri, sans compter des anomalies sur la direction réelle vers laquelle un adversaire faisait face. C'est de la désynchronisation de réplication, décrite par les joueurs avec leur propre vocabulaire.
Ailleurs, cela désigne une triche délibérée. En octobre 2025, le développeur Roblox loleris a signalé une faille de « desync » se propageant dans les jeux sur le forum officiel des développeurs. Grâce à elle, les mises à jour de position d'un tricheur parvenaient toujours au serveur mais cessaient de se répliquer sur les autres clients. Le résultat, comme le résume le sujet, est que « le serveur vous voit dans l'arène, mais tous les autres clients vous voient ailleurs, très loin », ce qui rend le joueur invisible et impossible à toucher. Les équipes de Roblox ont confirmé avoir reproduit le problème et ont déployé un correctif.
Même mot, intention opposée. Un fil de discussion se plaignant de « desync » peut décrire les limites de votre netcode, ou quelqu'un en train d'en abuser.
—
Cet article s'inspire et cite Latency Compensating Methods in Client/Server In-game Protocol Design and Optimization par Yahn W. Bernier (GDC 2001), 1500 Archers on a 28.8: Network Programming in Age of Empires and Beyond par Paul Bettner et Mark Terrano (GDC 2001, publié sur Game Developer), la série Fast-Paced Multiplayer par Gabriel Gambetta, et la documentation des concepts fondamentaux de SnapNet par High Horse Entertainment. Tous les droits sur le contenu original appartiennent à leurs propriétaires respectifs.
Écrit par
Jakub Motyl (Produit) et Gabriel Parent (Directeur)