Gestion des branches : le guide complet

La gestion des branches est l'une de ces pratiques qui est bien comprise au sein des grands studios et presque entièrement non documentée partout ailleurs. Les équipes qui l'ont mise en place l'écrivent rarement, car elle a été construite une fois pour toutes et est ensuite devenue invisible. Les équipes qui ne l'ont pas s'en rendent généralement compte à un moment inopportun.
Cet article rassemble les pratiques courantes en un seul endroit :
La première moitié couvre la poignée de concepts qu'il convient de comprendre avant de construire quoi que ce soit.
La seconde moitié décrit trois structures concrètes à différents niveaux de ressources disponibles : une pour un développeur solo, une pour une équipe de travail, et une pour un studio disposant d'un processus de publication formel.
Trois plutôt qu'une seule, car la bonne structure dépend du temps d'ingénierie que vous pouvez y consacrer. Un processus conçu pour un studio de cinquante personnes sera discrètement abandonné par une équipe de trois. Il n'y a pas de réponse unique correcte ici, et le sur-ingénierie à ce stade précoce comporte un coût réel. La structure qui fonctionne est celle que votre équipe suivra réellement.
Ce que signifie la gestion des branches
Si l'on écarte les outils, le problème se réduit à trois éléments.
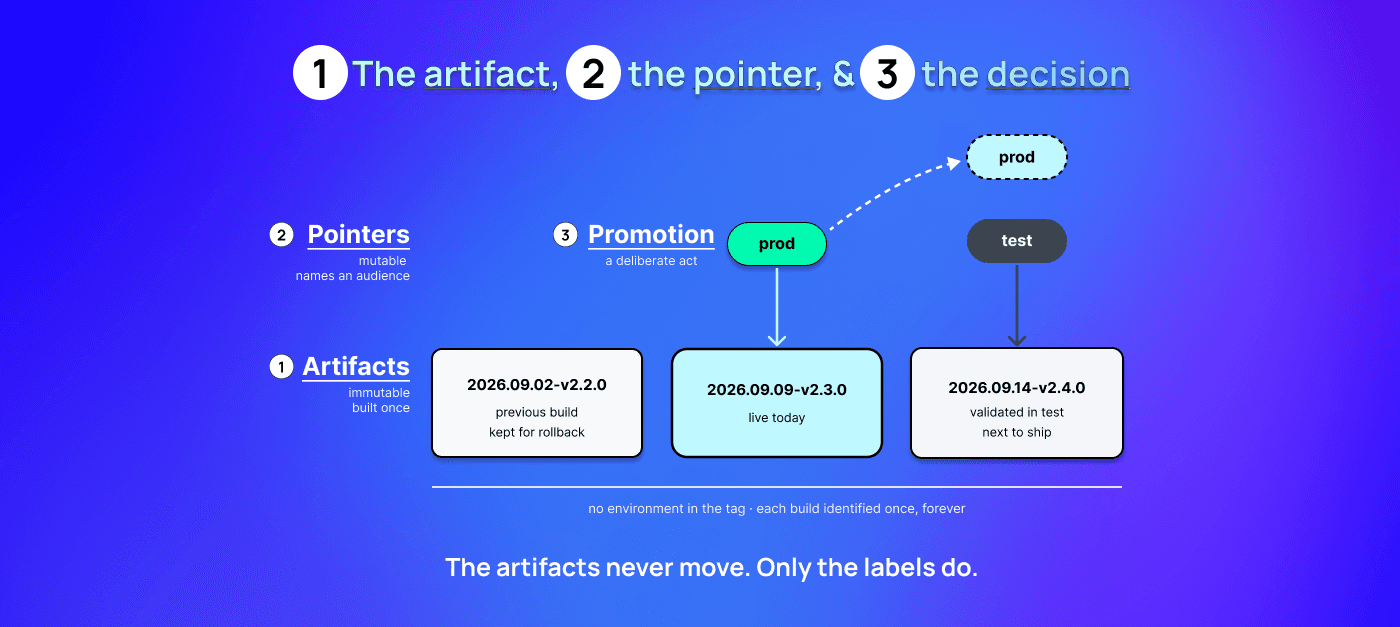
Un artéfact est une image de serveur construite. Une fois qu'il existe, il ne change jamais.
Un pointeur est un nom indiquant quel artéfact est actuel pour un public donné. « Production » est un pointeur, pas un objet.
Une décision est l'acte de déplacer un pointeur d'un artéfact à un autre.
Tout le reste n'est que de l'outillage enveloppé autour de ces trois éléments.
Certaines plateformes vous fournissent des branches nommées et un bouton de promotion. D'autres vous fournissent des versions et vous laissent décider de la signification des noms. Dans les deux cas, vous assemblez les trois mêmes éléments, et les approches ci-dessous diffèrent principalement par le niveau de formalité qui entoure le troisième.
Une distinction fait l'essentiel du travail ici : l'artéfact est immuable ; le pointeur ne l'est pas. La plupart des accidents de publication proviennent de la confusion entre les deux.
Concepts à connaître avant de choisir
Une seule build, plusieurs destinations
La même image qui s'exécute en test est l'image qui doit s'exécuter en production.
Pas une reconstruction à partir du même commit, pas une recompilation avec des drapeaux différents, mais les mêmes octets. Reconstruire par destination introduit un écart entre ce qui a été validé et ce qui a été livré, et cet écart est invisible jusqu'à ce que quelque chose en dépende. Les équipes convergent rapidement vers cela, car l'alternative est une classe de bogues qui ne se reproduit nulle part ailleurs que devant les joueurs.
Unicité des tags
Un tag réutilisé cesse d'être un identifiant et devient un label.
« Nous avons déployé la v2.3 » est une déclaration précise jusqu'à ce que quelqu'un pousse une image différente sous le même tag, moment auquel elle décrit deux builds selon le moment où vous posez la question. Attacher un élément unique à chaque tag, comme un numéro de build ou un hash de commit, permet de répondre à cette question plus tard. Cela ne coûte rien au moment de la construction et est difficile à intégrer après coup.
Un détail ici est facile à manquer. Un tag comme prod-2026.09.14-v2.3.0 semble logique, mais il place la destination à l'intérieur de l'identifiant, ce qui signifie que la build approuvée par la QA n'est pas celle qui est livrée. Garder l'environnement en dehors du tag (2026.09.14-v2.3.0) et l'associer plutôt au pointeur est ce qui rend la promotion possible sans reconstruction.
Les pointeurs et ce qu'ils pointent
Une fois l'artéfact figé, vous avez besoin de quelque chose de muable pour indiquer lequel est actif.
C'est le pointeur, et sur la plupart des plateformes, il s'agit d'une version nommée, d'une branche ou d'une valeur de configuration lue par votre outil de matchmaking. Son seul rôle est d'être modifiable, rapidement et de manière réversible, ce qui permet de faire fonctionner les deux concepts suivants.
Comment les choses avancent
Rien ne devrait passer du test à la production de manière planifiée, lors d'une fusion, ou comme effet secondaire d'autre chose.
La promotion fonctionne mieux lorsqu'elle constitue une action propre, distincte de la construction et du déploiement, car cette séparation permet à une personne ou à un contrôle de s'interposer entre une build et ses joueurs. Les équipes divergent sur l'identité de la personne qui l'exécute. Elles s'accordent généralement à dire qu'il doit s'agir d'un acte identifiable plutôt que d'une propriété émergente de la pipeline.
Revenir à une build précédente
Revenir en arrière signifie replacer les joueurs sur la build qui était active auparavant. La rapidité de cette opération dépend d'un choix fait plus tôt : si l'artéfact précédent existe toujours dans un endroit accessible.
Si c'est le cas, le retour en arrière est le même changement de pointeur que la promotion, mais exécuté à l'envers. Quelques secondes, et rien de nouveau ne peut casser. Si ce n'est pas le cas, le retour en arrière passe par un travail de build, qui prend le temps d'une build et peut échouer à sa manière. La différence ne réside pas dans l'outillage ou la compétence. Elle réside dans le fait d'avoir conservé ou non l'ancienne build.
Conserver une poignée de builds récentes consomme de l'espace dans le registre. La plupart des équipes trouvent cela moins coûteux que l'alternative.
Où réside la configuration
Certains paramètres diffèrent entre le test et la production : les régions à cibler, la base de données à interroger, les clés à utiliser. Ces valeurs peuvent soit être intégrées à la build, soit lui être fournies lors de son démarrage.
Si elles sont intégrées, la build de test et la build de production sont deux builds différentes, et le principe de « une seule build, plusieurs destinations » cesse discrètement d'être vrai. Si elles sont fournies au démarrage, généralement sous forme de variables d'environnement, une build unique reste valide partout.
La conclusion est simple. Si vous vous retrouvez à construire deux fois parce que deux environnements nécessitent des paramètres différents, c'est que les paramètres ne sont pas au bon endroit.
Builds froides et fenêtres de cache
Les plateformes qui distribuent des builds dans le monde entier maintiennent prêtes à l'emploi celles récemment utilisées, et laissent celles inutilisées sortir de cet état de préparation. Une build que personne n'a déployée depuis un certain temps peut nécessiter d'être récupérée à nouveau avant de pouvoir démarrer, ce qui allonge le temps du premier déploiement après une période d'inactivité.
Cela importe surtout pour le retour en arrière, car la build que vous souhaitez restaurer est par définition une build que vous avez cessé de déployer. Sur Edgegap, les images mises en cache expirent après 72 heures consécutives sans déploiement, de sorte qu'une build laissée inactive pendant un long week-end est froide le lundi.
Les équipes qui se soucient de la vitesse de retour en arrière déploient soit la build précédente occasionnellement pour la maintenir prête, soit acceptent le délai et planifient en conséquence. Les deux options sont raisonnables. Celle qui pose problème est de ne pas savoir quel choix a été fait.
Trois autres points méritent d'être nommés sans s'y attarder. Les builds clients et les versions de serveurs évoluent ensemble, de sorte qu'une promotion est également une décision de compatibilité. Le nettoyage du registre nécessite un plancher ainsi qu'un plafond, car « tout supprimer de plus de 30 jours » finit par supprimer l'élément vers lequel vous souhaitiez revenir. Et ce dont vous avez réellement besoin après un incident est précis : quelle image, promue par qui, quand.
Approche 1 : Deux versions et une règle
Pour les développeurs solos et les équipes de deux ou trois personnes, où la décision de publication se prend dans la tête d'une seule personne.
À cette échelle, le goulot d'étranglement n'est pas la coordination, c'est la mémoire. Il n'y a pas d'équipe QA pour valider ni de second ingénieur pour détecter une erreur, la structure doit donc être suffisamment simple pour qu'il soit plus difficile de l'ignorer que de la suivre. Deux versions est le minimum pour qu'une structure existe.
Tags 2026.09.14-1, 2026.09.14-2, 2026.09.15-1
Pointeurs test -> 2026.09.15-1
prod -> 2026.09.14-2
Suggestion clé | Passer à l'action |
|---|---|
Conserver exactement deux versions. |
|
Chaque build reçoit un tag jamais utilisé auparavant. Une date et un compteur suffisent. | Le but n'est pas l'élégance, mais qu'un tag ne puisse jamais être ambigu six semaines plus tard. |
Se déployer une build à soi-même signifie faire pointer | La publier signifie faire pointer |
Le retour en arrière est le même mouvement inverse, ce qui ne fonctionne que si vous vous souvenez du tag précédent. | Notez-le. Une ligne dans un fichier texte au sein du dépôt, mise à jour à chaque promotion, est peu glorieuse mais amplement suffisante. |
Nettoyer manuellement une fois par mois. | Supprimez les anciens tags, laissez tout ce qu'un pointeur référence actuellement. |
Ce que cela évite, c'est l'échec spécifique d'une build non révisée atteignant les joueurs.
Ce que cela ne vous donne pas, c'est un historique expliquant pourquoi une promotion a eu lieu ou ce qui a changé.
À trois personnes, c'est généralement acceptable, car il suffit de demander. Cela cesse de fonctionner à peu près lorsque la réponse à « qui a promu ceci ? » n'est plus évidente.
La configuration devrait prendre moins d'une heure. Le coût récurrent est d'une minute ou deux par publication.
Approche 2 : La CI possède la Staging, une personne possède la Production
Pour les équipes de studios de cinq à trente personnes environ, où les builds dépassent la capacité d'attention d'une seule personne.
Dès lors que les builds se produisent plus rapidement que quiconque ne peut les suivre, la division utile ne consiste pas à ajouter des environnements. La séparation préférable se fait entre ce qui est automatisé et ce qui reste manuel. Automatiser tout jusqu'à la production élimine le travail fastidieux. Laisser la dernière étape manuelle permet de garder un humain dans la boucle au seul moment où l'erreur coûte cher. C'est cette asymétrie qui fait l'intérêt de la démarche, et l'essentiel de la structure ci-dessous existe pour la soutenir.
Tags v1.4.2-a91c3f (semver + hash de commit court, produit par la CI)
Pointeurs dev -> construit à chaque push sur une branche de fonctionnalité
staging -> mis à jour automatiquement lors de la fusion vers main
prod -> mis à jour uniquement par un job de CI déclenché manuellement
Suggestion clé | En-tête 2 |
|---|---|
Les tags proviennent de la CI, jamais d'une personne | Le numéro de version indique à un humain ce qui a changé. Le hash rend la build reproductible à partir du seul tag, ce qui est plus important qu'il n'y paraît. |
La fusion vers main met à jour | La production est mise à jour par un job distinct, déclenché manuellement, qui prend un tag en entrée et l'associe au pointeur |
Ce qu'il faut savoir sur la couche plateforme ici. | Sur Edgegap, les versions d'applications sont muables, donc mettre à jour
|
Le nettoyage devient une tâche planifiée plutôt qu'une corvée mensuelle | La formule souhaitée par la plupart des équipes est « supprimer les versions de plus de trente jours, jamais moins que les dix dernières, et jamais rien de ce que référence un déploiement actif ». Edgegap ne dispose pas de moteur de politique de rétention aujourd'hui, cela est donc écrit via l'API plutôt que configuré. Environ un après-midi de travail, et la règle d'exclusion est la partie qui mérite le plus d'attention. |
Les builds clients et les versions de serveurs évoluent toujours ensemble | Les équipes de cette taille maintiennent généralement la version de production précédente déployable pendant un certain temps après la promotion, afin que les joueurs disposant d'un client obsolète ne soient pas bloqués en cours de session. |
L'avantage est que personne n'a besoin de se souvenir de quoi que ce soit, et l'historique de ce qui a été livré existe sans que personne n'ait à le maintenir.
Ce que cela ne fait toujours pas, c'est empêcher une promotion qui n'aurait pas dû avoir lieu. Un humain reste dans la boucle, et les humains approuvent des choses.
La configuration devrait prendre environ une journée de travail pour un ingénieur backend. Le coût récurrent est proche de zéro.
Approche 3 : Promotion auditable
Pour les studios ayant des opérations en direct, des exigences de conformité ou un processus de publication antérieur à la décision d'infrastructure.
À cette échelle, le processus de publication existe généralement déjà, défini par des personnes qui ne travaillent pas sur l'infrastructure, et le rôle de la plateforme est de s'y intégrer plutôt que de le remplacer. Cela modifie la question de conception. Le but n'est plus de maintenir le processus léger, mais de rendre chaque étape inspectable, car quelqu'un finira par demander ce qui a été livré, quand, et sous l'approbation de qui, et la réponse « je m'en souviens » ne suffit pas.
Tags v1.4.2-a91c3f (alias lisible par l'homme)
Identité sha256:9f2c... (ce sur quoi les déploiements s'alignent réellement)
Pointeurs staging -> digest
prod-canary -> digest
prod -> digest, modifié uniquement par un commit révisé et fusionné
Suggestion clé | Passer à l'action |
|---|---|
Des digests plutôt que des tags | Un tag est un label choisi par un humain, et les humains peuvent déplacer les labels. Un digest est un hash de contenu et ne peut pas être déplacé. Les studios qui associent les déploiements aux digests considèrent les tags purement comme des alias lisibles par l'homme. C'est la plus grande avancée en matière de rigueur disponible, et cela ne coûte rien d'autre qu'un changement dans ce que la CI enregistre. |
Des versions déclarées sous forme de code | Gérer les versions via Terraform ou l'API plutôt que par un tableau de bord transforme une promotion en une modification révisée et fusionnée avec un auteur, un horodatage et un diff. Le processus d'approbation existant du studio s'applique alors automatiquement, car la promotion est une pull request comme une autre. Les deux voies existent sur Edgegap, et c'est à ce niveau que cela importe le plus. Pour la couche inférieure, le guide d'Edgegap sur l'hébergement de serveurs de jeux évolutifs avec Docker ou Kubernetes explique comment les conteneurs eux-mêmes sont construits et exécutés. |
Des validations avant le déplacement du pointeur | Un test de rodage, un test de charge, une validation de la QA enregistrée dans un format lisible par machine. La distinction importante réside entre un processus que les gens suivent et un processus que la pipeline impose. Le second survit à une mauvaise semaine. |
Canari | Un pointeur distinct recevant une petite partie du trafic réel avant la promotion complète. Soyez lucide sur ce que cela implique : diriger les joueurs vers une version de serveur spécifique est une chose que les studios construisent aujourd'hui dans leur propre système de matchmaking ou de gestion de session, et non une fonctionnalité généralement fournie par les plateformes d'orchestration. Une version distincte, une règle de routage que vous possédez, et une fenêtre d'observation avec une définition convenue de ce qui est considéré comme sain. |
Signature et provenance | Images signées à la construction, signatures vérifiées à la promotion, promotion refusée en cas d'échec de la vérification. Il s'agit de plus en plus d'une exigence de conformité plutôt que d'une simple option de confort, en particulier pour les studios qui publient sur console. |
Rétention | Élagage automatisé comme dans l'approche 2, avec une règle stricte stipulant que rien de ce qui est référencé par un pointeur actif ou canari ne peut être supprimé, et avec enregistrement de la suppression elle-même. |
Tout cela est réalisable sur n'importe quelle plateforme qui expose des versions et une API, et rien de tout cela n'est réalisable sans des directives claires et une connaissance pratique du processus interne du studio.
Le temps nécessaire dépend entièrement de ce à quoi ressemble déjà ce processus.
Choisir entre les approches
Le signal utile n'est pas directement la taille de l'équipe. C'est la fréquence à laquelle la réponse à « qui a promu ceci, et pourquoi » nécessite de demander à quelqu'un.
Lorsque la réponse est évidente parce que vous êtes trois, l'approche 1 n'est pas un compromis, elle est correcte. Lorsque vous vous surprenez à poser la question, l'approche 2 est rentabilisée en un mois environ. Lorsque quelqu'un en dehors de l'équipe d'ingénierie a besoin de la réponse, vous êtes déjà dans le cadre de l'approche 3, que vous l'ayez construite ou non.
Il y a un compromis sous-jacent à tout cela qu'il convient d'énoncer clairement. Une plateforme qui vous impose une pipeline unique vous évite cette décision mais vous prive de la possibilité de faire différemment. Une plateforme qui vous fournit des versions et une API vous demande de choisir, ce qui n'est un fardeau que si personne ne choisit. La plupart des équipes mécontentes de l'une ou l'autre de ces configurations y sont parvenues par défaut plutôt que par décision.
Choisissez-en une délibérément, et comme pour tout développement logiciel, attendez-vous à y apporter des modifications, soit à grande échelle, soit une fois que le processus se sera solidifié. Une première structure claire est ce qui facilite la construction de la seconde.
Écrit par
Jakub Motyl (Produit), et Gabriel Parent (Directeur)