丢包
丢包是指未到达的数据。在 UDP 协议下,游戏不会等待它。客户端会根据其持有的最后一个状态继续进行预测,因此每次丢失更新都会延长其进行预测的时间窗口。当下一次更新到达时,修正幅度会更大,且显而易见。
,
当游戏数据包丢失时会发生什么?
多人游戏是双向的小型数据包流。玩家的客户端每秒向服务器发送多次输入,服务器则传回游戏世界的快照。许多游戏每个 tick 发送一个快照,而《Apex 英雄》服务器每秒 tick 20 次(Respawn,2021 年 4 月)。丢包意味着其中一些数据包永远无法到达。UDP 不会重试发送它们,比赛也不会暂停等待,因此接收方会继续使用它最后已知的信息。
丢失的代价取决于丢失的是哪个数据包:
丢失的快照(服务器到客户端)。客户端在此间隔内没有新状态。它会继续显示它拥有的最后一个状态,或者据此进行向前预测,当下一个快照到达时,其他玩家会瞬间移动到他们当前所在的位置。
丢失的输入(客户端到服务器)。服务器从未收到玩家按下按键的消息,因此它通常会使用最后收到的输入继续模拟玩家。玩家自己的客户端已经对该输入做出了反应,因此当服务器的回复到达时,它会被纠正。由 Mark Frohnmayer 和 Tim Gift 撰写的《部落2》(TRIBES II)网络论文将此描述为客户端和服务器端角色副本的偏离,并伴有短暂、肉眼可见的瞬移(TRIBES II 网络模型)。
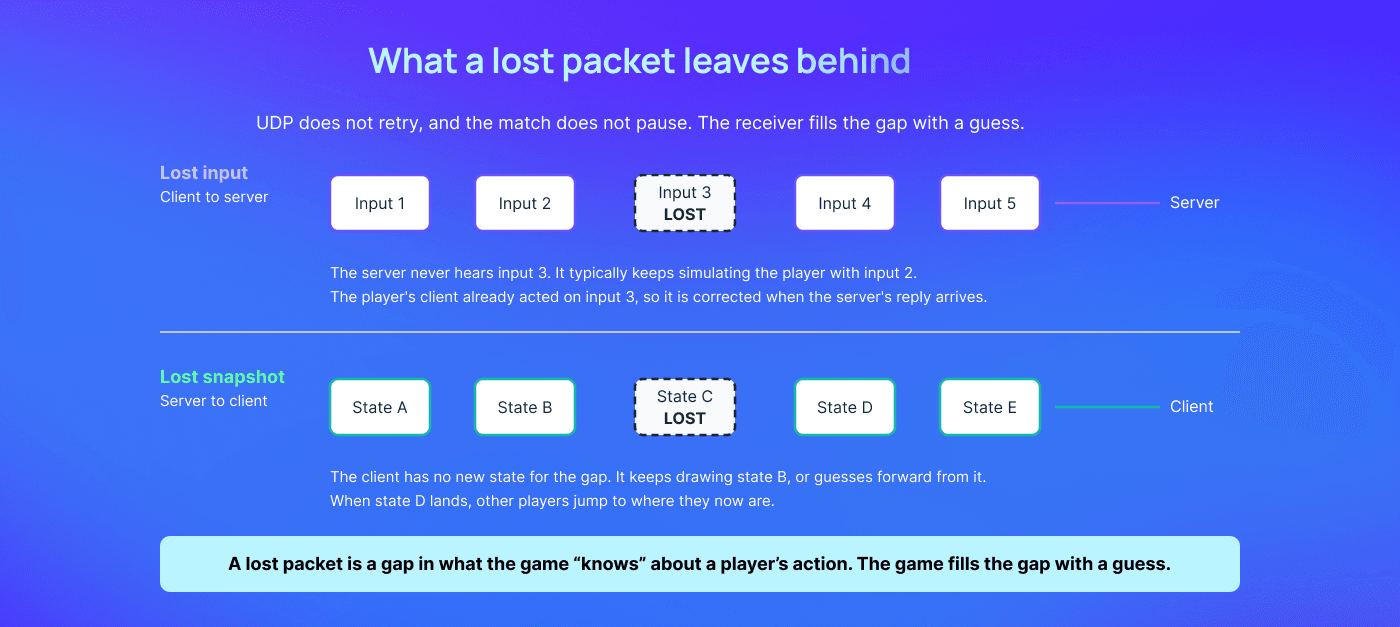
在这两种情况下,丢失的数据包都是游戏已知信息中的一个缺口,游戏会用预测来填补这个缺口。这些预测会变得有多大,以及游戏如何使它们保持在较小范围内,是本页其余部分的内容。纠正本身就是不同步所涉及的内容。

实践中 - 来自 Edgegap 博客的见解
文章的核心洞察
延迟存在下限,其他一切因素都在其之上累加:两台机器之间的物理传输时间是任何网络游戏所能拥有的最小延迟。路由、Tick率、更新率以及处理过程都会增加延迟。网络代码无法消除这种延迟,它只能决定玩家在何处感受到它。
最短路径很少是最快的:直接的P2P(点对点)连接看起来是两名玩家之间的最短路线,但数据包仍需经过两名玩家的互联网服务提供商(ISP)以及这些网络所选择的任何路由。在他们之间设立一个位置合理的服务器,往往既更快又更公平。
延迟补偿转移了代价,而不是消除了代价:延迟补偿会回溯服务器状态,以使高Ping玩家的射击有效,这意味着目标在到达掩体后仍可能被击中。唯一的真正解决办法是缩小Ping值差距,这使得它既是一个网络代码问题,也是一个匹配机制和服务器部署问题。
Tick率就是时间预算:服务器的Tick率设定了它模拟游戏每个步骤所拥有的毫秒数。更高的速率可以减少延迟并提高命中判定精度,但会消耗更多的CPU和带宽。超出预算的服务器会导致对局中的每个人都发生卡顿。
这是两个独立的选择,而非一个:游戏在哪里运行(P2P、中继或专用服务器)与状态如何共享(锁步同步、回滚同步或状态复制)是相互独立的决策。任何同步模型都可以在任何托管模型上运行。
游戏会重传哪些丢失的数据包,又会忽略哪些?
在 UDP 协议下,协议本身不会重传任何内容,因此由游戏来决定如何处理,且每次只处理一种数据。TRIBES II 的论文展示了三种常见的解决方案:
状态被替换,而非重传。当携带对象状态的数据包被报告丢失时,服务器不会重传该数据包的内容。它会将该对象发生变化的值重新标记为未发送,并在下一次机会发送该对象的当前状态,除非后面的数据包已经携带了该状态。论文将这种方法称为“最新状态”法,并表示它只能保证最新版本送达。
事件会被重传。开火射击或拾取物品只发生一次,下一个快照不会替换它。TRIBES II 会重新传输这些“保证”事件并按顺序进行处理。标记为“非保证”的事件则绝不重传。
输入会发送多次。每一次移动都会在连续的三个数据包中传输,因此只有在连续丢失三个数据包时,移动才会丢失。来自客户端的每个数据包都携带着服务器尚未确认的移动。
冗余是有代价的,论文也记录了这一点。最初的 TRIBES (1998) 将每个未确认的移动放入每个数据包中,这保证了送达。但是丢包扩大了窗口,更大的数据包更容易丢包,从而形成了恶性循环。TRIBES II 减少了重传次数以阻止这种情况。
出于同样的原因,输入窗口也需要设置上限。
游戏是如何隐藏丢失的更新的?
当状态确实丢失时,客户端仍必须绘制一些内容。Infinity Ward 在 2019 年《现代战争》的解释中(如 Edgegap 的《使命召唤》网络代码文章中所概述的那样),描述了三种解决方案,并根据每位玩家的连接情况进行混合使用:
缓冲(Buffering)使客户端稍微落后于最新数据,因此较晚的数据包不会导致卡顿。代价是延迟。
外推(Extrapolation)假设玩家继续做他们正在做的事情。代价是当他们改变方向时,会出现明显的突变。
预测(Prediction)将外推的输入视为服务器已确认的输入。代价是需要更大的修正,并且过多的修正会使游戏在糟糕的网络连接下难以进行。
每种解决方案都会将丢失转化为其他情况:延迟、猜测或修正。
而《守望先锋》则保护输入端。当服务器耗尽用于模拟的输入时,它会告诉客户端在一段时间内模拟得稍快一些,以便服务器的输入缓冲区在丢失导致错误预测之前重新填满。每个数据包还捆绑了服务器尚未确认的所有输入。这两点都出自 Timothy Ford 的 GDC 2017 演讲,正如 Edgegap 的《守望先锋》深度剖析中所概述的那样。代价再次转移:一些带宽以及时序上的微调。
为什么亏损模式比亏损比例更重要?
丢包率表示有多少数据包丢失。它并没有说明它们是如何丢失的,而这决定了玩家是否会察觉到。
每种防御机制都能覆盖特定长度的时间间隔,因此关键在于连续丢失了多少个数据包。以一个每秒 20 tick、每 tick 发送一次更新的服务器为例,这也是《Apex 英雄》服务器的运行速率(Respawn,2021 年 4 月)。每次丢失更新都会使间隔增加 50 毫秒。
丢失的内容 | 间隔时间 | 应对机制 |
|---|---|---|
单次快照 | 50 毫秒 | 插值缓冲区。Valve 的 Source 引擎默认为 100 毫秒,因此即使丢失一次更新,仍有两个更新可以进行混合(Valve)。 |
连续五个快照 | 250 毫秒 | 该缓冲区无法应对。客户端会保持最后的状态或进行外推,然后在下一次更新到达时进行修正。 |
连续一个或两个输入数据包 | 不适用 | 冗余。 TRIBES II 在连续三个数据包中发送每个动作。 |
连续三个输入数据包 | 不适用 | 未覆盖。这些数据包特有的动作为丢失,玩家的位置/状态将被修正。 |
两个连接的平均丢包率可能都是 5%。其中一个丢失的是孤立的数据包,上述防御机制通常可以吸收这些丢包。另一个则是成批丢失,防御机制对此无能为力。丢包百分比相同,但体验却完全不同。
因此,除了平均值之外,还要追踪每个玩家最长的连续丢包次数。这一个数字就能说明丢包是否被吸收了。这里的间隔时间是根据所引用的数字估算出来的。
更高的更新率会缩小每个间隔,但代价是带宽。Respawn 计算出,将 Apex 的更新率从 20 Hz 提高到 60 Hz 将使带宽增加到原来的三倍,从大约 60 kB/s 增加到 180 kB/s。

来自我们的赞助商(其实就是我们自己!)的寄语
大多数延迟来自距离,而非代码。Edgegap 的边缘云是一个分布式网络,按需提供高达 615+ 个可用位置,因此每场比赛都能在最适合玩家的可用位置运行。对直播工作室流量的独立重放测试表明,与公共云相比,平均往返时间减少了 58%。
如何确定损耗发生在何处?
Loss can start in four places, and the developer owns only one: the player's home network, their internet provider, the route between that provider and the data center, and the data center itself.
Respawn's 2021 deep dive found loss in several of them: on a player's provider network, on the link between a provider and its data center, and on return routes that differ from the outbound path. It also traced severe loss, across every game on a handful of servers, to one faulty network device in a data center, while the servers themselves were fine. Its own summary of most loss reports was that it is "probably not your fault", and usually not the developer's either (Respawn).
What separates the places is where the loss clusters. Loss that follows one player is their connection. Loss that follows one server, across many players, points at that host or its network. Loss that follows one provider, across many servers, points at the route.
Apex gave players a performance display in Season 6 that shows packet loss and choke as a percentage of packets per second. A player can report "10% packet loss, 300 ms latency" instead of "lag", and the developer gets numbers it can sort by player and server.
Two kinds of data answer different questions. Loss counters, per player and per server, show what did not arrive. A packet capture shows what each packet carried. Some netcode libraries record captures on the server: SnapNet's Unreal SDK writes them as JSON files that open in Chrome's tracing viewer, with segment widths proportional to the bits each entity and field uses (SnapNet documentation). That is bandwidth data, which is what tells you whether sending each input three times, or raising the update rate, is affordable. Their documentation advises capturing a few seconds at a time, because the files grow quickly.
Edgegap 的观点(仅代表个人意见,姑且听之即可!)
丢包通常始于游戏之外,因此请针对其进行设计并进行测量
数据包丢失(丢包)通常是由连接状况(包括 Wi-Fi 和家用硬件)决定的,而游戏的工作就是设法去应对它。Respawn 的数据也指向了同一个方向:运营商网络、进入数据中心的链路,以及某台故障设备。
因此,需要衡量游戏应对丢包的效果。记录每个方向的丢包率、每个玩家最长的连续丢包次数,并为每场比赛标记其服务器位置。将最长连续丢包次数与您的冗余窗口和缓冲区所能覆盖的范围进行对比。如果这些连续丢包在覆盖范围内,说明丢包已被吸收。如果超出了范围,则需要扩大防御机制,或者检查丢包是集中在某台服务器还是某个位置,因为这是您可以进行处理的硬件问题。
Edgegap 并不公布丢包数据,且任何服务器部署都无法解决玩家的家庭网络问题。然而,更短的路由确实能为包括 Wi-Fi 玩家在内的所有玩家腾出更多防御空间,因为重传或纠错需要消耗一个往返时间(RTT)。它还能缩小玩家之间的差距:在 Edgegap 2020 年的 1v1 研究中,基于每场比赛的部署在 66% 的比赛中缩小了这一差距,平均缩短了 31 毫秒(1v1 案例研究)。
,